Neuronale Netze sind eine zentrale Technologie im Bereich der Künstlichen Intelligenz. Sie orientieren sich lose an der Funktionsweise biologischer Gehirne und bestehen aus vielen miteinander verknüpften Einheiten, den künstlichen Neuronen. Diese Netze sind in der Lage, komplexe Muster zu erkennen, Sprach- oder Bilderkennung durchzuführen und Vorhersagen für verschiedenste Anwendungsfälle zu treffen. Das Verständnis von Aufbau, Lernverfahren und praktischem Einsatz bildet die Grundlage für die erfolgreiche Implementierung solcher Systeme.
Grundlagen neuronaler Netze
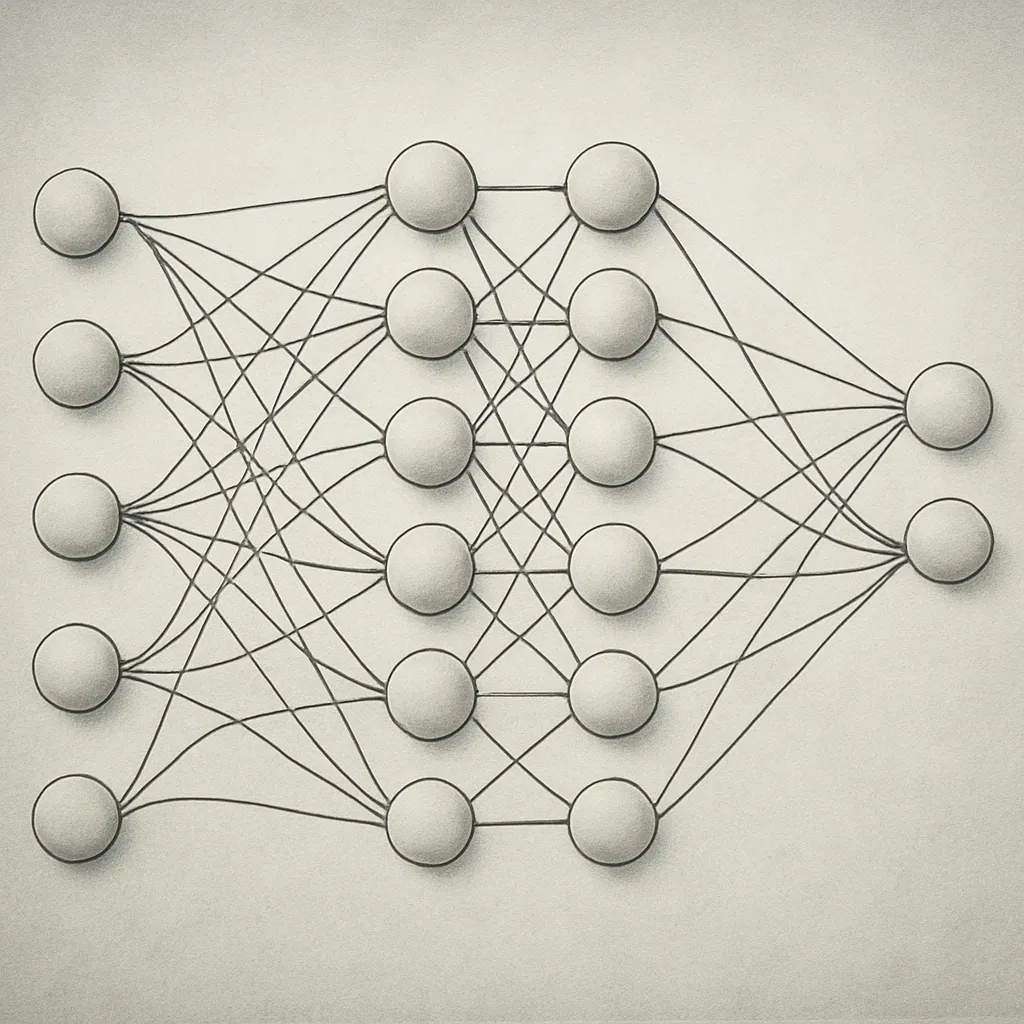
Ein künstliches neuronales Netz kann man sich als ein mehrlagiges System vorstellen, das aus folgenden Elementen besteht:
- Eingabeschicht: Übernimmt externe Daten wie Bilder, Sprache oder Sensormessungen.
- Verborgene Schichten: Eine oder mehrere Schichten von Neuronen, die Merkmale abstrahieren und Muster herausfiltern.
- Ausgabeschicht: Liefert das Ergebnis, etwa eine Klassifizierung oder eine Vorhersage.
Jede Verbindung zwischen Neuronen ist mit einem Gewicht versehen. Diese Gewichte bestimmen, wie stark ein Signal von einer Schicht zur nächsten weitergegeben wird. Zusätzlich besitzt jedes Neuron einen Bias-Wert, der einen Schwellenwert verschiebt. Die Kombination von Gewichten und Bias-Werten bildet zusammen einen parametrisierten Repräsentationsraum, in dem das Netz lernt, geeignete Werte für die gegebene Aufgabe zu finden.
Im Kernprozess multipliziert ein Neuron die eingehenden Signale mit den entsprechenden Gewichten, summiert sie auf und wendet schließlich eine Aktivierungsfunktion an. Typische Aktivierungsfunktionen sind die Sigmoid-, Tanh- oder ReLU-Funktion. Sie sorgen dafür, dass das Netz nicht nur lineare Beziehungen abbildet, sondern auch nichtlineare Zusammenhänge lernt.
Architektur und Funktionsweise
Die Wahl der Architektur hat großen Einfluss auf die Leistungsfähigkeit eines neuronalen Netzes. Gängige Architekturen sind:
- Feedforward-Netze: Signale fließen nur in eine Richtung, von Eingabe zu Ausgabe.
- Convolutional Neural Networks (CNNs): Speziell für Bild- und Mustererkennung durch Faltungsschichten.
- Recurrent Neural Networks (RNNs): Berücksichtigen Zeit- oder Reihenfolgedaten durch Rückkopplungsschleifen.
- Autoencoder: Lernen, Daten komprimiert darzustellen und eignen sich für Dimensionsreduktion.
Vorwärts- und Rückwärtspropagation
Der Ablauf eines Trainingsschritts lässt sich in zwei Phasen unterteilen:
- Vorwärtspropagation: Die Eingabedaten werden Schicht für Schicht weitergegeben und transformiert. Am Ende entsteht eine Vorhersage.
- Rückpropagation: Die Differenz zwischen Vorhersage und tatsächlichem Wert (Fehler) wird berechnet. Anschließend werden die Gradienten der Fehlerfunktion bezüglich der Gewichte bestimmt und zurück durch das Netz propagiert.
Durch diesen Mechanismus lernen die Gewichte, sich so zu verändern, dass der Gesamtfehler minimiert wird. Ein populäres Verfahren zur Gewichtsaktualisierung ist der Gradientenabstieg, bei dem man in Richtung des stärksten negativen Gradienten der Fehlerfunktion geht. Varianten wie Stochastic Gradient Descent und adaptive Methoden (Adam, RMSProp) verbessern Konvergenzgeschwindigkeit und Stabilität.
Training und Optimierung
Das eigentliche Training eines neuronalen Netzes besteht aus vielen Iterationen über den Datensatz. Wichtige Aspekte dabei sind:
- Batch-Größe: Bestimmt, wie viele Datenpunkte pro Optimierungsschritt verwendet werden.
- Lernrate: Regelt, wie groß die Schritte im Parameterraum sind. Zu hohe Lernraten führen oft zu Instabilität, zu niedrige verlangsamen das Training.
- Regularisierung: Methoden wie L1/L2-Strafen oder Dropout verhindern Overfitting und unterstützen die Generalisation auf unbekannte Daten.
- Early Stopping: Beendet das Training, wenn sich die Validierungsfehler nicht weiter verbessern, um übermäßiges Lernen auf das Training Set zu vermeiden.
Ein weiterer Schlüssel ist die Auswahl einer geeigneten Fehlerfunktion (Loss-Funktion). Für Klassifikationsaufgaben wird häufig die Kreuzentropie genutzt, während bei Regressionsaufgaben der mittlere quadratische Fehler (MSE) beliebt ist. Die richtige Kombination aus Architektur, Optimierungsalgorithmus und Hyperparametern bestimmt letztlich den Erfolg des Modells.
Anwendungsbereiche
Neuronale Netze finden sich heute in zahlreichen Branchen und Einsatzszenarien:
- Medizinische Bildanalyse: Erkennung von Tumoren oder Anomalien in Röntgen- und MRT-Aufnahmen.
- Sprachverarbeitung: Automatische Transkription, Übersetzung und virtuelle Assistenten.
- Finanzwesen: Vorhersage von Marktverläufen, Kreditwürdigkeitsprüfung und Betrugserkennung.
- Autonome Fahrzeuge: Objekterkennung, Kollisionsvorhersage und Entscheidungsfindung in Echtzeit.
- Empfehlungssysteme: Personalisierte Produkt- und Inhaltsvorschläge in E-Commerce und Streaming-Plattformen.
Zusätzlich entstehen immer neue Forschungsrichtungen wie Reinforcement Learning, bei dem Agenten durch Belohnung und Bestrafung lernen, und Generative Adversarial Networks (GANs), die realistische Bilder oder Texte erzeugen. Diese Entwicklungen verdeutlichen, dass neuronale Netze nicht nur gegenwärtig eine Schlüsselrolle in der KI-Forschung spielen, sondern auch maßgeblich zukünftige Innovationen prägen werden.