Textgenerierung beschäftigt sich mit der automatischen Erzeugung von natürlichsprachlichen Inhalten durch Computerprogramme. Dieser Prozess basiert auf komplexen Algorithmen und großen Datenmengen, um kohärente, sinnvolle Texte zu erstellen. In diesem Artikel werden die wichtigsten Konzepte, Methoden und Herausforderungen rund um die Textgenerierung vorgestellt.
Grundlagen der Textgenerierung
Die automatische Texterstellung setzt an grundlegenden Prinzipien der künstlichen Intelligenz (KI) und des NLP (Natural Language Processing) an. Ziel ist es, Texte zu produzieren, die nachweislich verständlich, thematisch passend und stilistisch konsistent sind. Dabei spielen Daten, mathematische Modelle und Rechenleistung eine entscheidende Rolle.
uWas ist Textgenerierung?
Unter Textgenerierung versteht man die Fähigkeit eines Systems, aus einer Eingabe oder einem Anstoß heraus vollständige Sätze, Absätze oder ganze Dokumente zu erstellen. Dies kann regelbasiert erfolgen oder auf statistischen und lernbasierten Ansätzen beruhen. Das Ergebnis soll möglichst natürlich wirken, sodass menschliche Leser kaum einen Unterschied zu von Menschen verfassten Texten erkennen.
uWichtige Begriffe
- Token: Grundbausteine von Texten, z. B. Wörter oder Wortteile.
- Kontext: Umfeld eines Tokens oder Satzes, das zur Erzeugung genutzt wird.
- Training: Lernprozess, bei dem Modelle anhand großer Datensätze optimiert werden.
- Parameter: Einstellgrößen in neuronalen Netzwerken.
- Inference: Phase, in der neue Texte generiert werden.
Methoden und Modelle
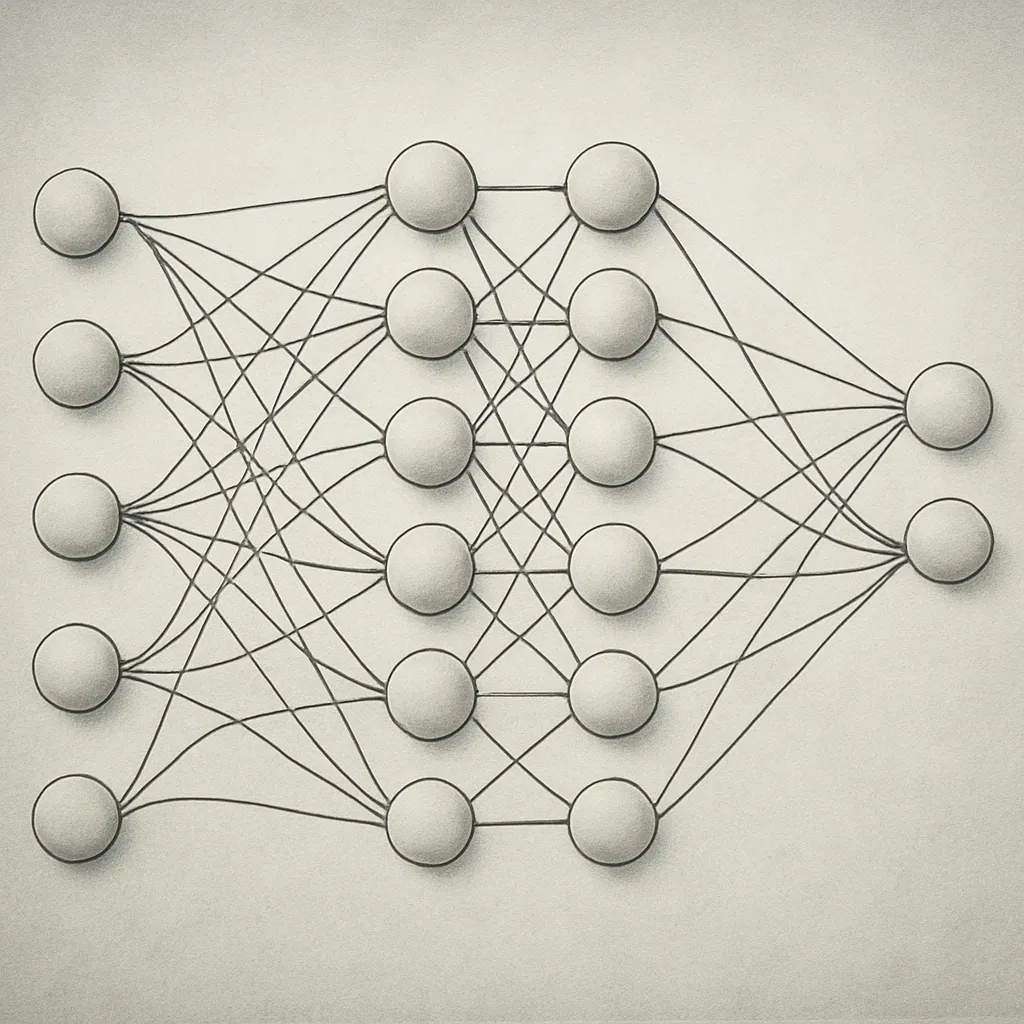
Im Lauf der letzten Jahre haben sich verschiedene Modelltypen etabliert, die das Feld der Textgenerierung maßgeblich geprägt haben. Im Zentrum stehen hierbei Neuronale Netzwerke, insbesondere architekturelle Weiterentwicklungen wie RNNs, LSTMs und Transformer-Modelle.
RNNs und LSTMs
Rekurrente neuronale Netzwerke (RNNs) nutzen die Reihenfolge von Eingaben, um vorhergehende Informationen zu behalten. LSTMs (Long Short-Term Memory) verbessern RNNs durch spezielle Speicherzellen, die längere Abhängigkeiten verwalten können. Beide Modelltypen waren bis vor einigen Jahren die Basis für automatische Übersetzer, Chatbots und Textvorhersagen.
Transformer-Modelle
Der Durchbruch in der Textgenerierung gelang mit der Einführung der Transformer-Modelle. Sie arbeiten nicht sequenziell, sondern parallel und verwenden das sogenannte Attention-Verfahren, um Kontexte über große Distanzen zu berücksichtigen. Bekannte Vertreter sind BERT, GPT und T5. Diese Modelle sind in der Lage, sehr komplexe Texte zu erzeugen und auf spezifische Aufgaben angepasst zu werden.
Feinabstimmung und Transfer Learning
Ein wichtiger Fortschritt ist das Transfer Learning. Zunächst wird ein Modell auf riesigen, allgemeinen Datensätzen vortrainiert. Im Anschluss erfolgt die Feinabstimmung (Fine-Tuning) auf spezifische Domänen oder Aufgaben. So werden universelle Sprachkenntnisse mit domänenspezifischen Inhalten kombiniert. Dieser Ansatz reduziert benötigte Datenmengen und Rechenressourcen für neue Anwendungen.
Anwendungsgebiete und Herausforderungen
Automatische Textgenerierung findet mittlerweile in vielen Bereichen Anwendung. Trotz beeindruckender Ergebnisse bleiben Herausforderungen bei Qualität, Ethik und technischen Aspekten bestehen.
Anwendungsbereiche
- Journalismus: Automatischer Nachrichten- und Berichtsgenerator
- Marketing: Erzeugung von Werbetexten, Produktbeschreibungen, Social-Media-Posts
- Kundenservice: Chatbots und virtuelle Assistenten
- Übersetzung: Maschinenübersetzer mit Text-Post-Editing
- Bildung: Erstellung von Lernmaterialien, Zusammenfassungen, Vokabeltraining
Qualitäts- und Ethikaspekte
Bei automatisierten Texten drohen Fehlinformationen, Vorurteile und ungewollte Inhalte. Modelle übernehmen Verzerrungen aus Trainingsdaten und können stereotype oder falsche Aussagen generieren. Durch kontinuierliche Validierung und menschliches Review lässt sich die Qualität verbessern. Ein verantwortungsvoller Umgang und transparente Kommunikation sind unerlässlich.
Technische Herausforderungen
- Skalierbarkeit: Trainingskosten für große Modelle sind hoch.
- Speicherbedarf: Milliarden von Parametern erfordern viel RAM und Speicherplatz.
- Echtzeitfähigkeit: Inferenz muss schnell und ressourcenschonend erfolgen.
- Domänenanpassung: Modelle müssen auf verschiedene Themengebiete zugeschnitten werden.
Zukunftsperspektiven
Die Forschung im Bereich der Textgenerierung schreitet rasant voran. Neue Ansätze wie **multimodale Modelle**, die Text, Bild und Audio kombinieren, eröffnen spannende Möglichkeiten. Gleichzeitig wird an effizienteren Architekturen und sparsamen Trainingsverfahren gearbeitet, um den ökologischen Fußabdruck zu reduzieren.
In den kommenden Jahren dürften Systeme entstehen, die noch stärker personalisierte, kreative und kontextbewusste Inhalte liefern. Kooperationen zwischen Mensch und Maschine werden wichtiger, um kreative Prozesse zu unterstützen. Dabei bleibt der verantwortungsvolle Einsatz zentral, um die Qualität, Transparenz und ethische Integrität der generierten Texte zu gewährleisten.